这里是差集:Docling 全量解析 text block 减去最终会进入正文的 block。优先人工检查 risk=high / medium。
layout_review.html excluded_blocks.json excluded_blocks.tsv final_body_blocks.tsv visual_assets.tsv original.pdf
{
  "parsed_text_blocks": 91,
  "final_body_blocks": 22,
  "excluded_blocks": {
    "count": 69,
    "by_reason": {
      "after_back_matter_stop": 21,
      "docling_page_header": 18,
      "outside_body_flow_caption": 9,
      "first_page_author_or_affiliation": 6,
      "body_heading": 4,
      "first_page_metadata": 3,
      "abstract_heading": 1,
      "back_matter_heading": 1,
      "before_body_started": 1,
      "docling_caption": 1,
      "document_web_address": 1,
      "first_page_front_matter_heading": 1,
      "first_page_summary": 1,
      "front_matter_heading": 1
    },
    "by_role_guess": {
      "page_header": 18,
      "reference": 17,
      "affiliation": 10,
      "caption": 10,
      "body_heading": 6,
      "back_matter_heading": 2,
      "abstract_heading": 1,
      "body_candidate_excluded": 1,
      "footnote": 1,
      "front_matter_heading": 1,
      "metadata": 1,
      "page_footer": 1
    },
    "by_risk_level": {
      "low": 68,
      "medium": 1
    },
    "high_risk_count": 0,
    "medium_risk_count": 1
  },
  "char_counts": {
    "parsed_text_chars": 21558,
    "final_body_chars": 15683,
    "excluded_chars": 5875
  }
}
{
  "truncated": true,
  "message": "Body extraction stopped at page 10 block #/texts/66: Acknowledgement. 21 following text blocks were excluded as after_back_matter_stop.",
  "stop_trigger": {
    "ref": "#/texts/66",
    "page": 10,
    "layout_order": 69,
    "role_guess": "back_matter_heading",
    "body_decision_reason": "back_matter_heading",
    "text_preview": "Acknowledgement"
  },
  "first_truncated_block": {
    "ref": "#/texts/67",
    "page": 10,
    "layout_order": 70,
    "role_guess": "body_candidate_excluded",
    "body_decision_reason": "after_back_matter_stop",
    "text_preview": "Experiments at PLS were supported in part by POSTECH."
  },
  "truncated_block_count": 21,
  "truncated_pages": [
    10
  ],
  "by_role_guess": {
    "reference": 15,
    "affiliation": 4,
    "back_matter_heading": 1,
    "body_candidate_excluded": 1
  }
}
这些框显示被排除块,同时叠加真实图表资产框。青色虚线表示该 text block 被图表资产 caption 吸收;红色 STOP 是截断触发点,红色框是截断后被排除的块。
这是实际图表资产输出,不是审计层重新推断。
| # | type | label | page | caption source | suppressed | duplicate reason | rescue reason | group | confidence | bbox | caption |
|---|---|---|---|---|---|---|---|---|---|---|---|
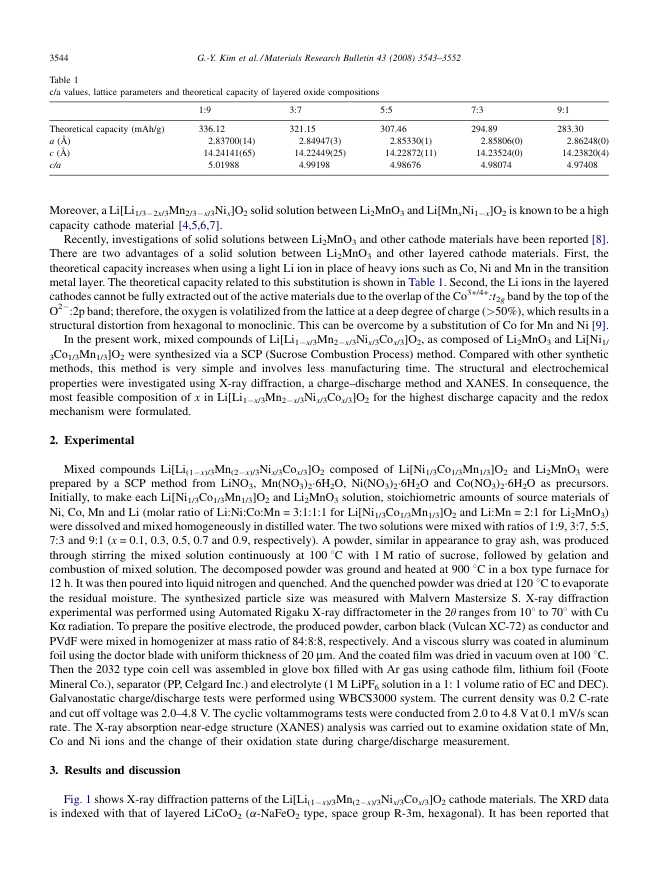
| 1 | figure | Fig. 1 | 3 | direct_caption_ref | 0.82 | [146.03, 61.95, 249.17, 173.37] | Fig. 1. XRD patterns of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. | ||||
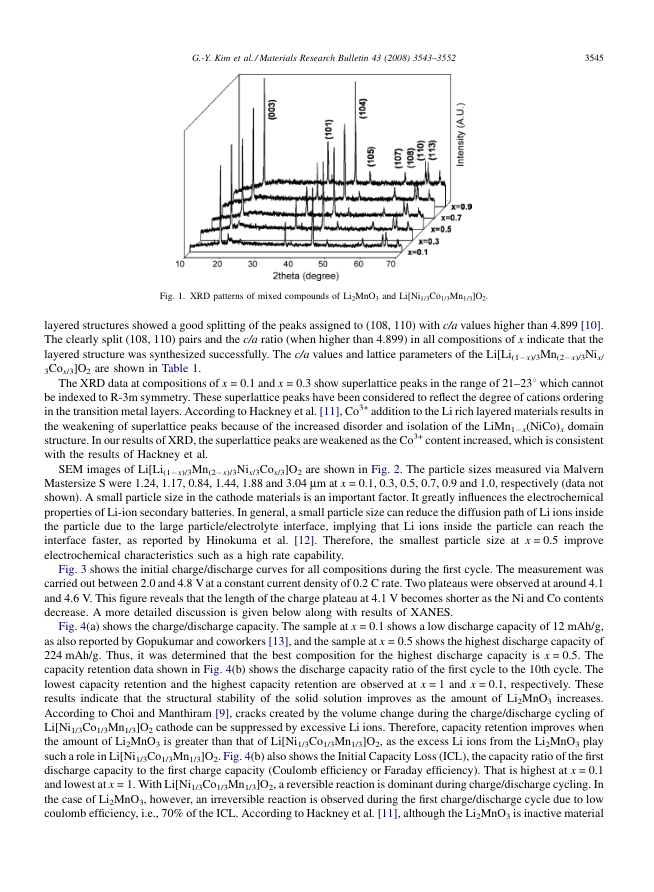
| 2 | figure | Fig. 2 | 4 | direct_caption_ref | 0.82 | [57.05, 61.21, 433.75, 492.05] | Fig. 2. SEM images of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. x = (a) 1.0, (b) 0.9, (c) 0.7, (d) 0.5, (e) 0.3 and (f) 0.1. | ||||
| 3 | figure | Fig. 3 | 5 | direct_caption_ref | 0.82 | [152.06, 60.67, 235.65, 365.55] | Fig. 3. First charge/discharge curves of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. | ||||
| 4 | figure | Fig. 4 | 6 | direct_caption_ref | 0.82 | [153.24, 61.51, 242.42, 376.61] | Fig. 4. (a) Electrochemical properties of mixed compounds ofLi2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2: ( & ) charge capacity and ( * ) discharge capacity. (b) Electrochemical properties of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2: ( & ) capacity retention and ( * ) initial capacity loss. | ||||
| 5 | figure | Fig. 5 | 7 | nearby_text_caption | 0.82 | [149.33, 61.61, 239.86, 178.42] | Fig. 5. Cycle performance of the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound after fifty cycles. | ||||
| 6 | figure | Fig. 6 | 7 | direct_caption_ref | 0.82 | [150.56, 282.17, 238.63, 173.87] | Fig. 6. Cyclic voltammograms of the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound. Scan rate is 0.1 mV/s. The voltage range is 2.0 -4.8 V. | ||||
| 7 | figure | Fig. 7 | 7 | direct_caption_ref | 0.82 | [149.22, 492.89, 240.55, 174.41] | Fig. 7. Voltage profile of the cell during two cycles. Representative scans of XANES measurements are indicated. | ||||
| 8 | figure | Fig. 8 | 8 | direct_caption_ref | 0.82 | [151.76, 60.75, 244.92, 557.46] | Fig. 8. (a) Mn K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. (b) Co K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. (c) Ni K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. | ||||
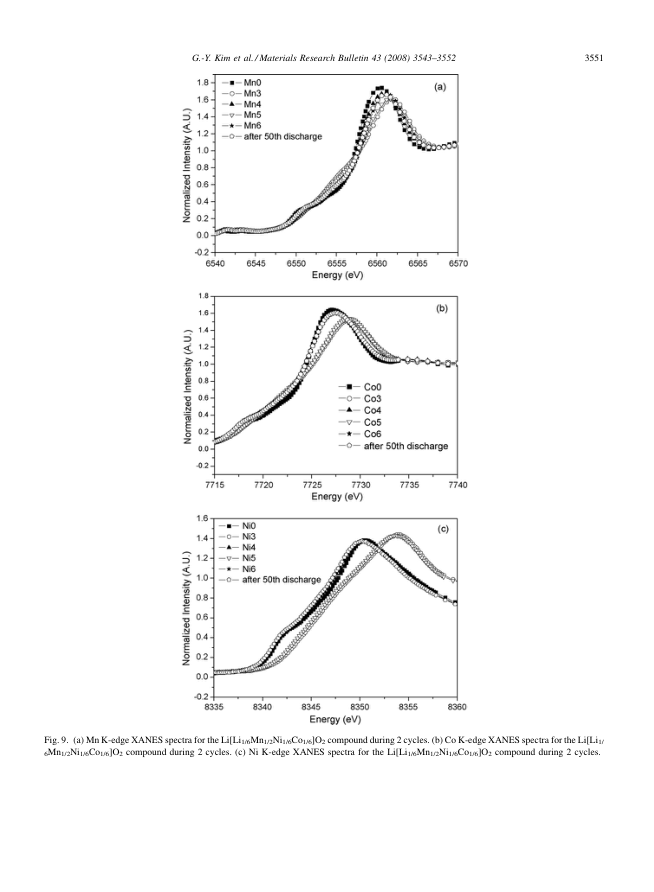
| 9 | figure | Fig. 9 | 9 | direct_caption_ref | 0.82 | [149.93, 61.61, 240.7, 543.61] | Fig. 9. (a) Mn K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. (b) Co K-edge XANES spectra for the Li[Li1/ 6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. (c) Ni K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. | ||||
| 10 | table | Docling Table 10 | 2 | missing_caption | 0.55 | [40.11, 83.95, 467.97, 62.92] |
| risk | page | order | label | role | reason | parser reason | production usage | trunc | body region | region | bg | bbox | raw text | cleaned text |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| medium | 10 | 70 | text | body_candidate_excluded | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [53.07, 411.17, 240.66, 8.69] | Experiments at PLS were supported in part by POSTECH. | Experiments at PLS were supported in part by POSTECH. | ||
| low | 1 | 0 | text | body_heading | before_body_started | before_body_started | p1:front_matter:left_crossing:white | [255, 255, 255] white | [171.89, 99.61, 163.34, 6.95] | Materials Research Bulletin 43 (2008) 3543 -3552 | Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 1 | 1 | text | metadata | document_web_address | document_web_address | p1:front_matter:right:white | [255, 255, 255] white | [391.75, 109.07, 111.36, 6.95] | www.elsevier.com/locate/matresbu | ||||
| low | 1 | 2 | section_header | body_heading | first_page_front_matter_heading | first_page_front_matter_heading | p1:front_matter:full:white | [255, 255, 255] white | [50.12, 143.16, 439.71, 54.63] | Electrochemical behaviors of Li[Li(1 x )/3Mn(2 x )/3Ni x /3Co x /3]O2 cathode series (0 < x < 1) synthesized by sucrose combustion process for high capacity lithium ion batteries | Electrochemical behaviors of Li[Li(1 x )/3Mn(2 x )/3Ni x /3Co x /3]O2 cathode series (0 < x < 1) synthesized by sucrose combustion process for high capacity lithium ion batteries | |||
| low | 1 | 3 | text | affiliation | first_page_author_or_affiliation | first_page_author_or_affiliation | p1:front_matter:left_crossing:white | [255, 255, 255] white | [91.16, 207.17, 357.6, 14.17] | Gu-Yeon Kim a, * , Seung-Beob Yi b , Yong Joon Park c , Ho-Gi Kim a | Gu-Yeon Kim a, * , Seung-Beob Yi b , Yong Joon Park c , Ho-Gi Kim a | |||
| low | 1 | 4 | text | affiliation | first_page_author_or_affiliation | first_page_author_or_affiliation | p1:front_matter:full:white | [255, 255, 255] white | [59.19, 227.9, 418.91, 18.57] | a Department of Materials Science and Engineering, Korea Advanced Institute of Science and Technology, 373-1 Guseong-dong, Yuseong-gu, Daejeon 305-701, Republic of Korea | a Department of Materials Science and Engineering, Korea Advanced Institute of Science and Technology, 373-1 Guseong-dong, Yuseong-gu, Daejeon 305-701, Republic of Korea | |||
| low | 1 | 5 | text | affiliation | first_page_author_or_affiliation | first_page_author_or_affiliation | p1:front_matter:left_crossing:white | [255, 255, 255] white | [115.03, 247.86, 307.31, 8.59] | b Energy Business Division Development Team, SAMSUNG SDI, 508 Sungsung-dong, Chenan, | b Energy Business Division Development Team, SAMSUNG SDI, 508 Sungsung-dong, Chenan, | |||
| low | 1 | 6 | text | affiliation | first_page_author_or_affiliation | first_page_author_or_affiliation | p1:front_matter:left_crossing:white | [255, 255, 255] white | [189.24, 259.66, 161.46, 6.77] | Chungcheongnam-do 330-300, Republic of Korea | Chungcheongnam-do 330-300, Republic of Korea | |||
| low | 1 | 7 | text | affiliation | first_page_author_or_affiliation | first_page_author_or_affiliation | p1:front_matter:left_crossing:white | [255, 255, 255] white | [95.64, 267.76, 346.04, 8.65] | c Division of Advanced Industrial Engineering, Kyonggi University, 94-6 Yiui-dong, Yeongtong-gu, Suwon, | c Division of Advanced Industrial Engineering, Kyonggi University, 94-6 Yiui-dong, Yeongtong-gu, Suwon, | |||
| low | 1 | 8 | text | affiliation | first_page_author_or_affiliation | first_page_author_or_affiliation | p1:front_matter:left_crossing:white | [255, 255, 255] white | [219.35, 279.56, 101.26, 6.77] | Kyonggi-do, Republic of Korea | Kyonggi-do, Republic of Korea | |||
| low | 1 | 9 | text | reference | first_page_metadata | first_page_metadata | p1:front_matter:left_crossing:white | [255, 255, 255] white | [105.45, 292.47, 329.04, 16.93] | Received 9 November 2007; received in revised form 21 December 2007; accepted 17 January 2008 Available online 29 January 2008 | Received 9 November 2007; received in revised form 21 December 2007; accepted 17 January 2008 Available online 29 January 2008 | |||
| low | 1 | 10 | section_header | abstract_heading | abstract_heading | abstract_heading | p1:front_matter:left:white | [255, 255, 255] white | [36.85, 329.56, 33.31, 7.9] | Abstract | Abstract | |||
| low | 1 | 11 | text | reference | first_page_summary | first_page_summary | p1:front_matter:full:white | [255, 255, 255] white | [36.85, 346.64, 466.27, 73.59] | A mixed cathode material between Li2MnO3 and Li[Mn1/3Ni1/3Co1/3]O2 for high capacity lithium secondary batteries was introduced in this study. It was prepared using the sucrose combustion process because this is a simple process. The oxidation states (1 x )/3Mn(2 x )/3Ni x /3Co x /3]O2 compounds were confirmed to be tetravalent, trivalent and divalent, respectively, via XANES measurements. Electrochemical charge/discharge studies showed that the highest first discharge capacity of 224 mAh/g was obtained in composition of x = 0.5 at a 0.2 C rate. The oxidation state of the Co and Ni ions in the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 changed to higher oxidation states, but that of the Mn ions did not change. # 2008 Elsevier Ltd. All rights reserved. | A mixed cathode material between Li2MnO3 and Li[Mn1/3Ni1/3Co1/3]O2 for high capacity lithium secondary batteries was introduced in this study. It was prepared using the sucrose combustion process because this is a simple process. The oxidation states (1 x )/3Mn(2 x )/3Ni x /3Co x /3]O2 compounds were confirmed to be tetravalent, trivalent and divalent, respectively, via XANES measurements. Electrochemical charge/discharge studies showed that the highest first discharge capacity of 224 mAh/g was obtained in composition of x = 0.5 at a 0.2 C rate. The oxidation state of the Co and Ni ions in the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 changed to higher oxidation states, but that of the Mn ions did not change. # 2008 Elsevier Ltd. | |||
| low | 1 | 12 | text | front_matter_heading | front_matter_heading | front_matter_heading | p1:front_matter:full:white | [255, 255, 255] white | [36.85, 431.43, 408.25, 6.95] | Keywords: A. Inorganic compounds; B. Chemical synthesis; C. XAFS (EXAFS and XANES); D. Electrochemical properties | Keywords: A. Inorganic compounds; B. Chemical synthesis; C. XAFS (EXAFS and XANES); D. Electrochemical properties | |||
| low | 1 | 13 | section_header | body_heading | body_heading | body_heading | p1:body_zone:left:white | [255, 255, 255] white | [36.85, 473.51, 66.61, 8.78] | 1. Introduction | 1. Introduction | |||
| low | 1 | 16 | footnote | footnote | first_page_metadata | first_page_metadata | p1:body_zone:left:white | [255, 255, 255] white | [41.39, 633.6, 172.87, 16.93] | * Corresponding author. Fax: +82 42 869 8650. E-mail address: antiserra@kaist.ac.kr (G.-Y. Kim). | * Corresponding author. Fax: +82 42 869 8650. E-mail address: antiserra@kaist.ac.kr (G.-Y. Kim). | |||
| low | 1 | 17 | page_footer | page_footer | first_page_metadata | first_page_metadata | p1:body_zone:left_crossing:white | [255, 255, 255] white | [36.85, 665.33, 240.11, 17.06] | 0025-5408/$ -see front matter # 2008 Elsevier Ltd. All rights reserved. doi:10.1016/j.materresbull.2008.01.011 | 0025-5408/$ -see front matter # 2008 Elsevier Ltd. All rights reserved. doi:10.1016/j.materresbull.2008.01.011 | |||
| low | 2 | 18 | page_header | page_header | docling_page_header | docling_page_header | p2:top_margin:left:white | [255, 255, 255] white | [41.16, 45.41, 15.94, 6.95] | 3544 | 3544 | |||
| low | 2 | 19 | page_header | page_header | docling_page_header | docling_page_header | p2:top_margin:right_crossing:white | [255, 255, 255] white | [164.3, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 2 | 20 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p2:front_matter:left_crossing:white | [255, 255, 255] white | [41.16, 63.78, 274.88, 16.93] | Table 1 c/a values, lattice parameters and theoretical capacity of layered oxide compositions | Table 1 c/a values, lattice parameters and theoretical capacity of layered oxide compositions | |||
| low | 2 | 24 | section_header | body_heading | body_heading | body_heading | p2:body_zone:left:white | [255, 255, 255] white | [41.16, 363.19, 70.77, 8.78] | 2. Experimental | 2. Experimental | |||
| low | 2 | 26 | section_header | body_heading | body_heading | body_heading | p2:body_zone:left:white | [255, 255, 255] white | [41.16, 638.15, 109.24, 8.78] | 3. Results and discussion | 3. Results and discussion | |||
| low | 3 | 28 | page_header | page_header | docling_page_header | docling_page_header | p3:top_margin:left_crossing:white | [255, 255, 255] white | [159.99, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 3 | 29 | page_header | page_header | docling_page_header | docling_page_header | p3:top_margin:right:white | [255, 255, 255] white | [487.22, 45.41, 15.94, 6.95] | 3545 | 3545 | |||
| low | 3 | 30 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p3:page_body:left_crossing:white | [255, 255, 255] white | [133.11, 243.89, 273.72, 7.7] | Fig. 1. XRD patterns of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. | Fig. 1. XRD patterns of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. | |||
| low | 4 | 36 | page_header | page_header | docling_page_header | docling_page_header | p4:top_margin:left:white | [255, 255, 255] white | [41.16, 45.41, 15.94, 6.95] | 3546 | 3546 | |||
| low | 4 | 37 | page_header | page_header | docling_page_header | docling_page_header | p4:top_margin:right_crossing:white | [255, 255, 255] white | [164.3, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 4 | 38 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p4:page_body:full:white | [255, 255, 255] white | [48.59, 562.05, 451.38, 7.7] | Fig. 2. SEM images of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. x = (a) 1.0, (b) 0.9, (c) 0.7, (d) 0.5, (e) 0.3 and (f) 0.1. | Fig. 2. SEM images of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. x = (a) 1.0, (b) 0.9, (c) 0.7, (d) 0.5, (e) 0.3 and (f) 0.1. | |||
| low | 5 | 41 | page_header | page_header | docling_page_header | docling_page_header | p5:top_margin:left_crossing:white | [255, 255, 255] white | [159.99, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 5 | 42 | page_header | page_header | docling_page_header | docling_page_header | p5:top_margin:right:white | [255, 255, 255] white | [487.22, 45.41, 15.94, 6.95] | 3547 | 3547 | |||
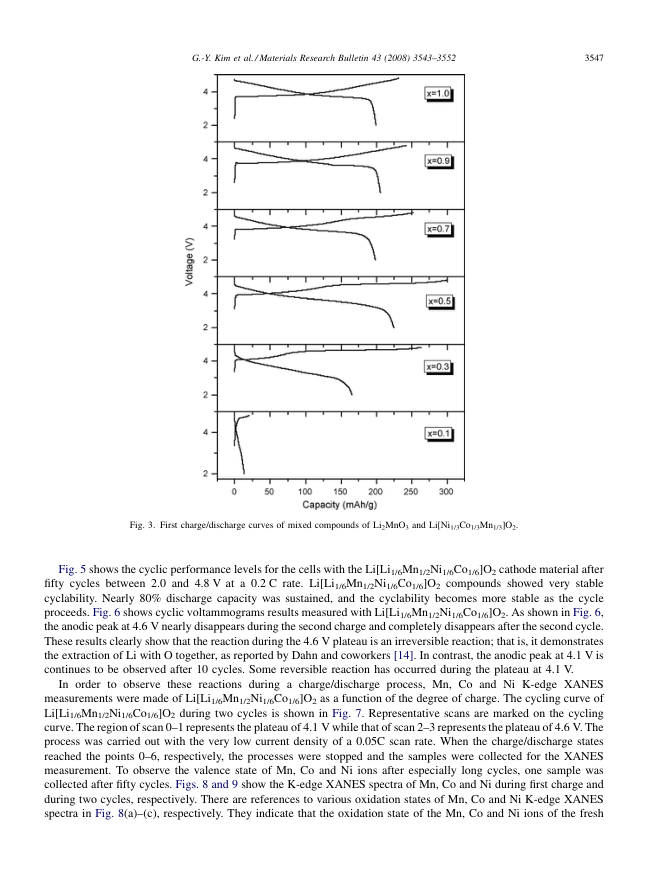
| low | 5 | 43 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p5:page_body:left_crossing:white | [255, 255, 255] white | [108.17, 434.43, 323.61, 7.75] | Fig. 3. First charge/discharge curves of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. | Fig. 3. First charge/discharge curves of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2. | |||
| low | 6 | 46 | page_header | page_header | docling_page_header | docling_page_header | p6:top_margin:left:white | [255, 255, 255] white | [41.16, 45.41, 15.94, 6.95] | 3548 | 3548 | |||
| low | 6 | 47 | page_header | page_header | docling_page_header | docling_page_header | p6:top_margin:right_crossing:white | [255, 255, 255] white | [164.3, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
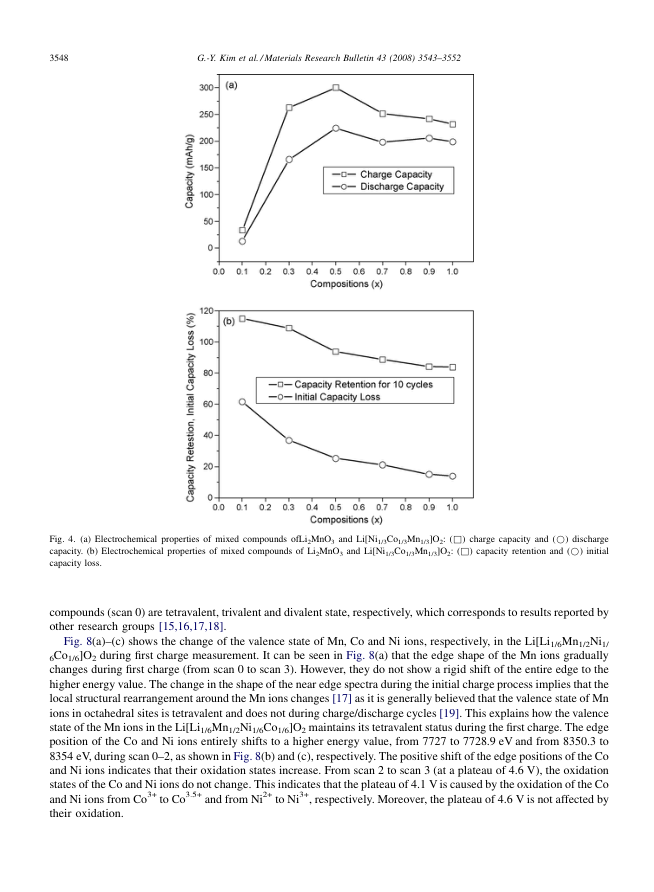
| low | 6 | 48 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p6:page_body:full:white | [255, 255, 255] white | [41.16, 446.26, 466.28, 27.33] | Fig. 4. (a) Electrochemical properties of mixed compounds ofLi2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2: ( & ) charge capacity and ( * ) discharge capacity. (b) Electrochemical properties of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2: ( & ) capacity retention and ( * ) initial capacity loss. | Fig. 4. (a) Electrochemical properties of mixed compounds ofLi2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2: ( & ) charge capacity and ( * ) discharge capacity. (b) Electrochemical properties of mixed compounds of Li2MnO3 and Li[Ni1/3Co1/3Mn1/3]O2: ( & ) capacity retention and ( * ) initial capacity loss. | |||
| low | 7 | 51 | page_header | page_header | docling_page_header | docling_page_header | p7:top_margin:left_crossing:white | [255, 255, 255] white | [159.99, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 7 | 52 | page_header | page_header | docling_page_header | docling_page_header | p7:top_margin:right:white | [255, 255, 255] white | [487.22, 45.41, 15.94, 6.95] | 3549 | 3549 | |||
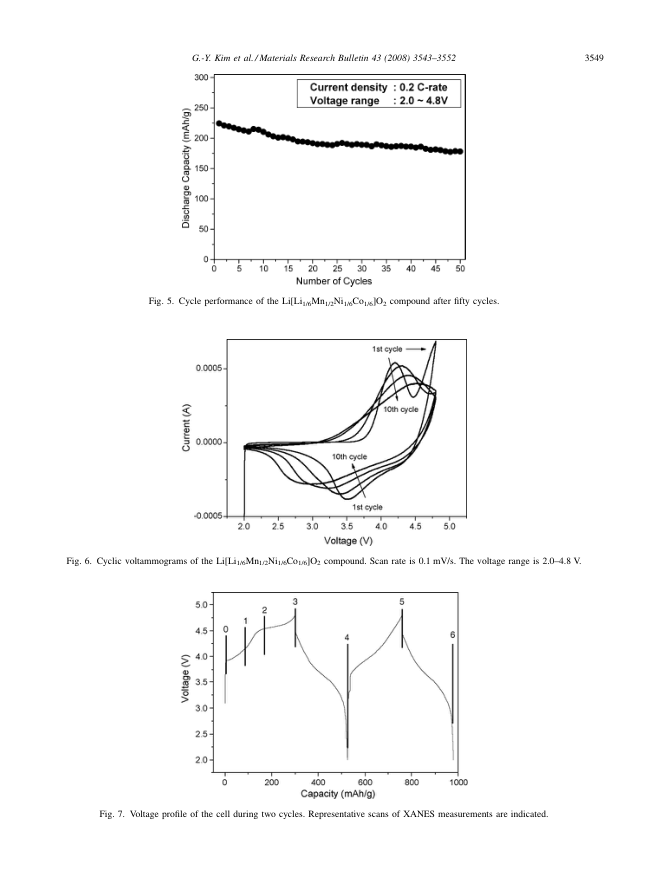
| low | 7 | 53 | caption | caption | docling_caption | docling_caption | p7:page_body:left_crossing:white | [255, 255, 255] white | [123.87, 248.31, 292.28, 7.75] | Fig. 5. Cycle performance of the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound after fifty cycles. | Fig. 5. Cycle performance of the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound after fifty cycles. | |||
| low | 7 | 54 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p7:page_body:full:white | [255, 255, 255] white | [55.39, 464.42, 429.17, 7.7] | Fig. 6. Cyclic voltammograms of the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound. Scan rate is 0.1 mV/s. The voltage range is 2.0 -4.8 V. | Fig. 6. Cyclic voltammograms of the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound. Scan rate is 0.1 mV/s. The voltage range is 2.0 -4.8 V. | |||
| low | 7 | 55 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p7:page_body:left_crossing:white | [255, 255, 255] white | [82.94, 675.32, 374.11, 6.95] | Fig. 7. Voltage profile of the cell during two cycles. Representative scans of XANES measurements are indicated. | Fig. 7. Voltage profile of the cell during two cycles. Representative scans of XANES measurements are indicated. | |||
| low | 8 | 56 | page_header | page_header | docling_page_header | docling_page_header | p8:top_margin:left:white | [255, 255, 255] white | [41.16, 45.41, 15.94, 6.95] | 3550 | 3550 | |||
| low | 8 | 57 | page_header | page_header | docling_page_header | docling_page_header | p8:top_margin:right_crossing:white | [255, 255, 255] white | [164.3, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
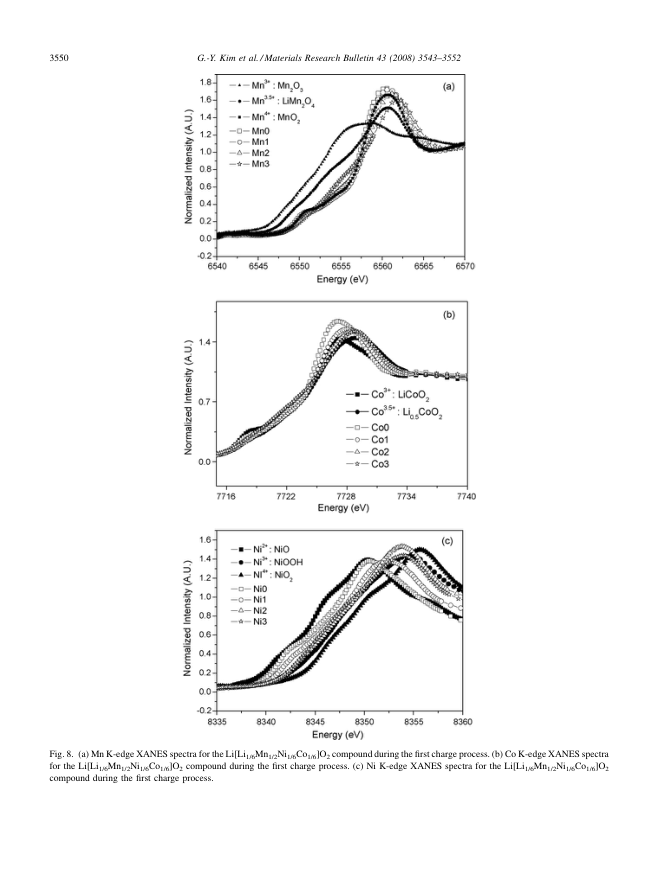
| low | 8 | 58 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p8:page_body:full:white | [255, 255, 255] white | [41.16, 625.94, 466.25, 26.91] | Fig. 8. (a) Mn K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. (b) Co K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. (c) Ni K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. | Fig. 8. (a) Mn K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. (b) Co K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. (c) Ni K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during the first charge process. | |||
| low | 9 | 59 | page_header | page_header | docling_page_header | docling_page_header | p9:top_margin:left_crossing:white | [255, 255, 255] white | [159.99, 45.41, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 9 | 60 | page_header | page_header | docling_page_header | docling_page_header | p9:top_margin:right:white | [255, 255, 255] white | [487.22, 45.41, 15.94, 6.95] | 3551 | 3551 | |||
| low | 9 | 61 | caption | caption | outside_body_flow_caption | outside_body_flow_caption | p9:page_body:full:white | [255, 255, 255] white | [36.85, 613.58, 466.26, 17.68] | Fig. 9. (a) Mn K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. (b) Co K-edge XANES spectra for the Li[Li1/ 6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. (c) Ni K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. | Fig. 9. (a) Mn K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. (b) Co K-edge XANES spectra for the Li[Li1/ 6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. (c) Ni K-edge XANES spectra for the Li[Li1/6Mn1/2Ni1/6Co1/6]O2 compound during 2 cycles. | |||
| low | 10 | 62 | page_header | page_header | docling_page_header | docling_page_header | p10:top_margin:left:white | [255, 255, 255] white | [41.16, 45.4, 15.94, 6.95] | 3552 | 3552 | |||
| low | 10 | 63 | page_header | page_header | docling_page_header | docling_page_header | p10:top_margin:right_crossing:white | [255, 255, 255] white | [164.3, 45.4, 219.98, 6.95] | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | G.-Y. Kim et al. / Materials Research Bulletin 43 (2008) 3543 -3552 | |||
| low | 10 | 66 | section_header | body_heading | body_heading | body_heading | p10:body_zone:left:white | [255, 255, 255] white | [41.16, 243.68, 63.93, 8.78] | 4. Conclusions | 4. Conclusions | |||
| low | 10 | 69 | section_header | back_matter_heading | back_matter_heading | back_matter_heading | stop_trigger | p10:body_zone:left:white | [255, 255, 255] white | [41.16, 387.11, 78.62, 8.78] | Acknowledgement | Acknowledgement | ||
| low | 10 | 71 | section_header | back_matter_heading | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left:white | [255, 255, 255] white | [41.16, 434.96, 46.53, 8.78] | References | References | ||
| low | 10 | 72 | list_item | affiliation | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left:white | [255, 255, 255] white | [45.13, 458.3, 158.85, 6.95] | K. Ozawa, Solid State Ionics 69 (1994) 212. | K. Ozawa, Solid State Ionics 69 (1994) 212. | ||
| low | 10 | 73 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [45.13, 468.28, 305.85, 6.95] | Y.S. Hong, Y.J. Park, K.S. Ryu, S.H. Chang, Y.J. Shin, J. Power Sources 147 (2005) 214. | Y.S. Hong, Y.J. Park, K.S. Ryu, S.H. Chang, Y.J. Shin, J. Power Sources 147 (2005) 214. | ||
| low | 10 | 74 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [45.13, 478.26, 290.43, 6.95] | Z. Lu, D.D. MacNeil, J.R. Dahn, Electrochem. Solid-State Lett. 4 (12) (2001) A200. | Z. Lu, D.D. MacNeil, J.R. Dahn, Electrochem. Solid-State Lett. 4 (12) (2001) A200. | ||
| low | 10 | 75 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [45.13, 488.18, 298.37, 6.95] | Y.J. Park, Y.S. Hong, X. Wu, K.S. Ryu, S.H. Chang, J. Power Sources 129 (2004) 288. | Y.J. Park, Y.S. Hong, X. Wu, K.S. Ryu, S.H. Chang, J. Power Sources 129 (2004) 288. | ||
| low | 10 | 76 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left:white | [255, 255, 255] white | [45.13, 498.16, 199.16, 6.95] | S.H. Kang, K. Amine, J. Power Sources 124 (2003) 533. | S.H. Kang, K. Amine, J. Power Sources 124 (2003) 533. | ||
| low | 10 | 77 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [45.13, 508.13, 356.42, 6.95] | Z. Lu, L.Y. Beaulieu, R.A. Donaberger, C.L. Thomas, J.R. Dahn, J. Electrochem. Soc. 149 (2002) A778. | Z. Lu, L.Y. Beaulieu, R.A. Donaberger, C.L. Thomas, J.R. Dahn, J. Electrochem. Soc. 149 (2002) A778. | ||
| low | 10 | 78 | list_item | affiliation | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left:white | [255, 255, 255] white | [45.13, 518.06, 207.56, 6.95] | A.D. Robertson, P.G. Bruce, Chem. Mater. 15 (2003) 1984. | A.D. Robertson, P.G. Bruce, Chem. Mater. 15 (2003) 1984. | ||
| low | 10 | 79 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [45.13, 528.03, 273.36, 6.95] | S.H. Kang, Y.K. Sun, K. Amine, Electrochem. Solid-State Lett. 6 (2003) A183. | S.H. Kang, Y.K. Sun, K. Amine, Electrochem. Solid-State Lett. 6 (2003) A183. | ||
| low | 10 | 80 | list_item | affiliation | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [45.13, 538.01, 258.23, 6.95] | J. Choi, A. Manthiram, Electrochem. Solid-State Lett. 7 (10) (2004) A365. | J. Choi, A. Manthiram, Electrochem. Solid-State Lett. 7 (10) (2004) A365. | ||
| low | 10 | 81 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [41.16, 547.99, 286.01, 6.95] | K.M. Shaju, G.V. Subba Rao, B.V.R. Chowdari, Electrochim. Acta 48 (2002) 145. | K.M. Shaju, G.V. Subba Rao, B.V.R. Chowdari, Electrochim. Acta 48 (2002) 145. | ||
| low | 10 | 82 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:full:white | [255, 255, 255] white | [41.16, 557.91, 413.41, 6.95] | M.M. Thackeray, S.-H. Kang, C.S. Johnson, VaugheyF J.T., R. Benedek, S.A. Hackney, J. Mater. Chem. 17 (2007) 3112. | M.M. Thackeray, S.-H. Kang, C.S. Johnson, VaugheyF J.T., R. Benedek, S.A. Hackney, J. Mater. Chem. 17 (2007) 3112. | ||
| low | 10 | 83 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [41.16, 567.89, 288.1, 6.95] | A. Yamada, S.C. Chung, K. Hinokuma, J. Electrochem. Soc. 148 (3) (2001) A224. | A. Yamada, S.C. Chung, K. Hinokuma, J. Electrochem. Soc. 148 (3) (2001) A224. | ||
| low | 10 | 84 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [41.16, 577.87, 283.12, 6.95] | P. Kalyani, S. Chitra, T. Mohan, S. Gopukumar, J. Power Sources 80 (1999) 103. | P. Kalyani, S. Chitra, T. Mohan, S. Gopukumar, J. Power Sources 80 (1999) 103. | ||
| low | 10 | 85 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left:white | [255, 255, 255] white | [41.16, 587.84, 216.39, 6.95] | Z. Lu, J.R. Dahn, J. Electrochem. Soc. 149 (7) (2002) A815. | Z. Lu, J.R. Dahn, J. Electrochem. Soc. 149 (7) (2002) A815. | ||
| low | 10 | 86 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [41.16, 597.77, 345.89, 6.95] | W.-S. Yoon, C.-P. Grey, M. Balasubramanian, X.-Q. Yang, M. James, Chem. Mater. 15 (2003) 3161. | W.-S. Yoon, C.-P. Grey, M. Balasubramanian, X.-Q. Yang, M. James, Chem. Mater. 15 (2003) 3161. | ||
| low | 10 | 87 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [41.16, 607.74, 311.29, 6.95] | Y.J. Park, X. Wu, HongF Y.-S., K.S. Ryu, S.H. Chang, Solid State Ionics 175 (2004) 305. | Y.J. Park, X. Wu, HongF Y.-S., K.S. Ryu, S.H. Chang, Solid State Ionics 175 (2004) 305. | ||
| low | 10 | 88 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:full:white | [255, 255, 255] white | [41.16, 617.72, 404.43, 6.95] | M. Balasubramanian, J. McBreen, I.J. Davidson, P.S. Whitfield, I. Kargina, J. Electrochem. Soc. 149 (2) (2002) A176. | M. Balasubramanian, J. McBreen, I.J. Davidson, P.S. Whitfield, I. Kargina, J. Electrochem. Soc. 149 (2) (2002) A176. | ||
| low | 10 | 89 | list_item | reference | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left_crossing:white | [255, 255, 255] white | [41.16, 627.7, 373.16, 6.95] | Y.J. Park, M.G. Kim, Y.-S. Hong, X. Wu, K.S. Ryu, S.H. Chang, Solid State Commun. 127 (2003) 509 -514. | Y.J. Park, M.G. Kim, Y.-S. Hong, X. Wu, K.S. Ryu, S.H. Chang, Solid State Commun. 127 (2003) 509 -514. | ||
| low | 10 | 90 | list_item | affiliation | after_back_matter_stop | after_back_matter_stop | after_stop | p10:body_zone:left:white | [255, 255, 255] white | [41.16, 637.62, 206.64, 6.95] | B. Ammundsen, J. Paulsen, J. Adv. Mater. 13 (2001) 943. | B. Ammundsen, J. Paulsen, J. Adv. Mater. 13 (2001) 943. |